База знаний Антона Сидорова
База знаний по аналитике, ИТ архитектуре, API. Документирование. Тесты инструментов.
Project maintained by daemon110282 Hosted on GitHub Pages — Theme by mattgraham
Kafka
Зачем
Реализация паттерна интеграции Message Broker.
UC:
- большие данные BigData и потоковую обработку Streaming Data
- Log processing and analysis
- Data streaming in recommendations
- System monitoring and alerting
- CDC (Change data capture)
- System migration
Плюсы и минусы
Плюсы:
- распределенный горизонтально масштабируемый
- отказоустойчивый журнал коммитов
- кластер серверов
- Шардинг из коробки
- Поток событий
- согласованность данных
- репликация топиков (replication-factor)
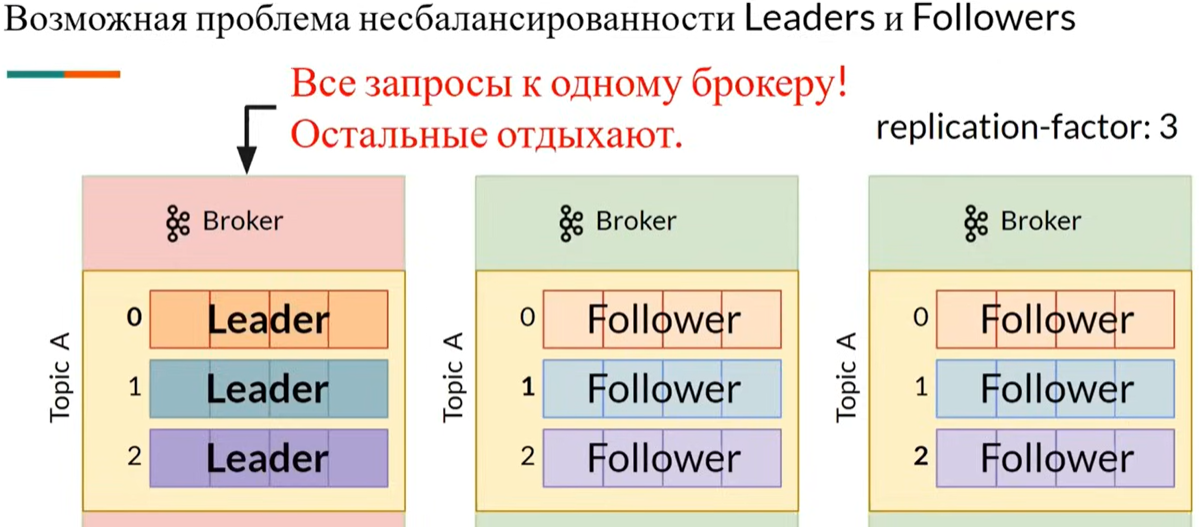
- master-slave (Leader-Follower)
- возможна задержка в данных. Запись сообщений всегда в Leader. Follower получает pull от Leader сообщения периодически
- in-sync replicas (ISR) - синхронная запись в Follower partition, замедляют запись сообщений
- репликация топиков (replication-factor)
- Strict message ordering (FIFO) by partition
- Message retention for extended periods, including the possibility of replaying past messages
- Сообщения в Kafka не удаляются брокерами по мере их обработки консьюмерами — данные в Kafka могут храниться днями, неделями, годами
- Благодаря этому одно и то же сообщение может быть обработано сколько угодно раз разными консьюмерами и в разных контекстах
- Группировка сообщений в пачки batch
- Транзакции между несколькими топиками
Минусы:
- Наиболее полно API Kafka поддерживается только в языках Java и Scala. В других языках поддержка не всегда полная, поэтому фреймворки Kafka Connect и Kafka Streams созданы.
- Нет приоритета сообщений
- Модель Pull (запрос)
- потенциальная разбалансированность нагрузки между разными консьюмерами
- более высокая задержка обработки данных
- разбалансировка партиций по брокерам кластера, может требоваться ручная балансировка по брокерам больших партиций
Функции
Фундаментальное отличие Kafka от брокеров очередей состоит в том:
- Сообщения хранятся на брокере, но есть ttl
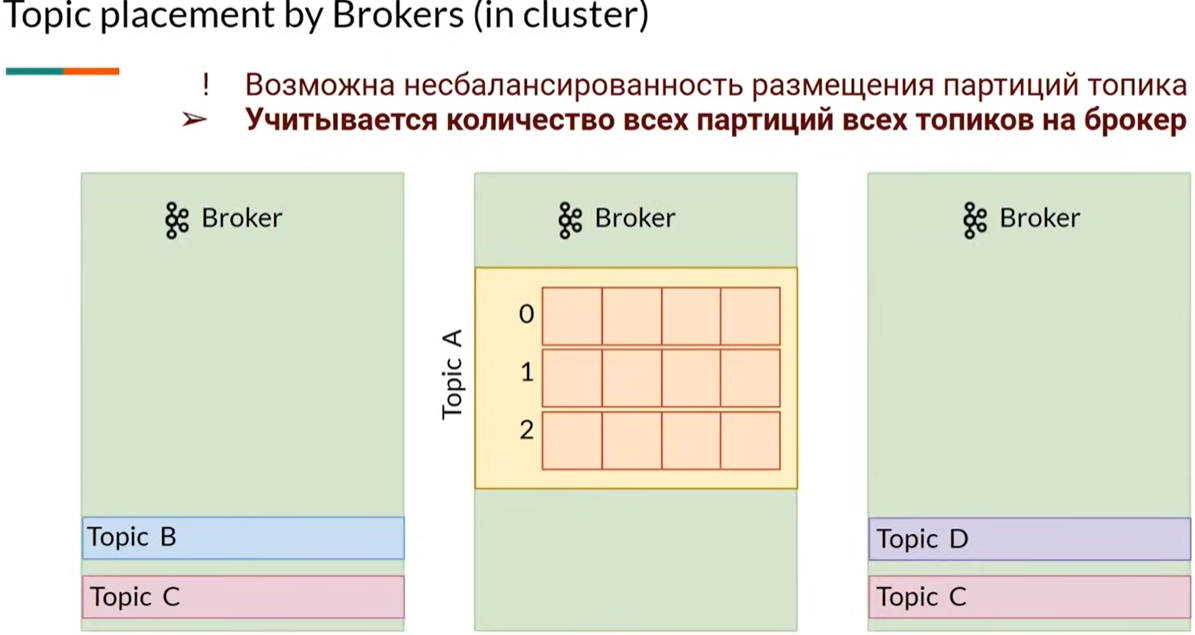
- Сообщения в Kafka организованы и хранятся в именованных топиках (Topics), каждый топик состоит из одной и более партиций (Partition), распределённых между брокерами внутри одного кластера
- Консьюмер потребляет сообщения через запрос (pull) (consumer)
- консьюмеры сами отправляют запросы в брокер (в RMQ push по умолчанию) раз в n миллисекунд для получения новой порции сообщений
- позволяет группировать сообщения в пакеты (batch), достигая лучшей пропускной способности
- отмечают (commit) обработанные сообщения с помощью оффсетов. Оффсет (Offset) – это номер сообщения в партиции
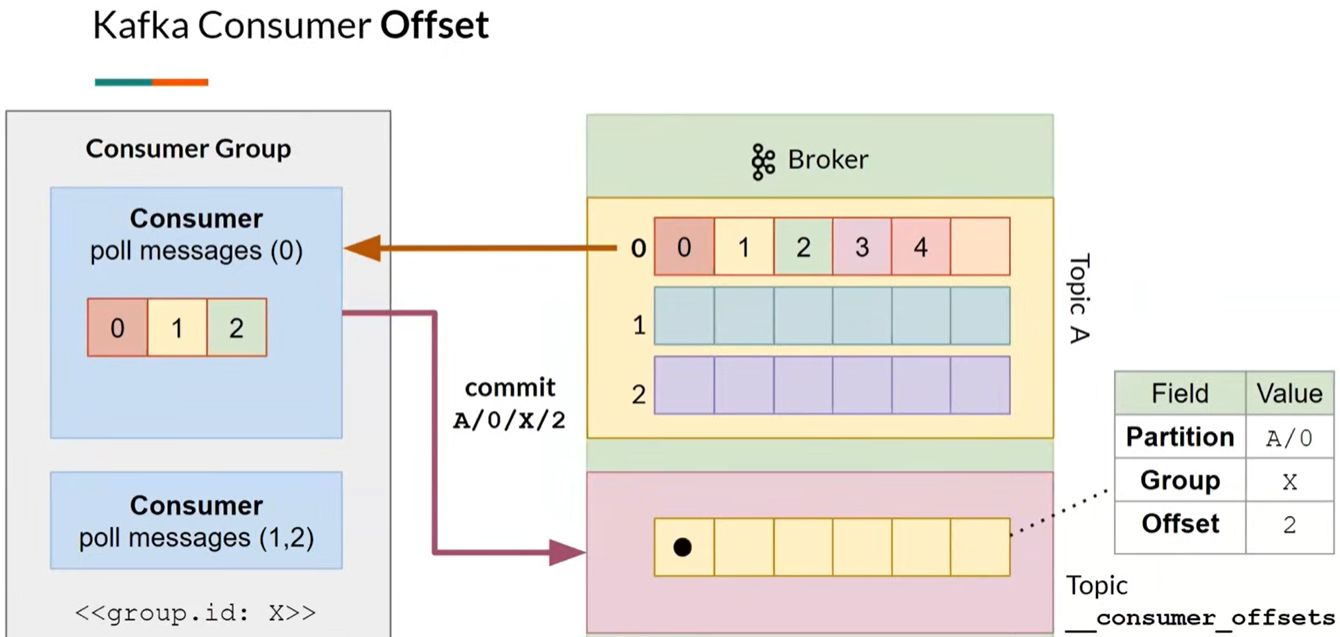
- либо об успешной обработке (offset-commit)
- либо об ошибке (offset-reset)
- type of commit
- auto commit - сразу после получения сообщения, до обработки: at most once (риск miss message)
- manual commit - после обработки сообщений: at least once (риск duplicate message)
- custom offset managment: exactly once
- consumer group - параллельное чтение данных из partition
- консьюмеры сами отправляют запросы в брокер (в RMQ push по умолчанию) раз в n миллисекунд для получения новой порции сообщений
Основные компоненты
Продюсеры (Producers)
- Генерируют сообщения/события к обработке и отправляют в топики (темы)
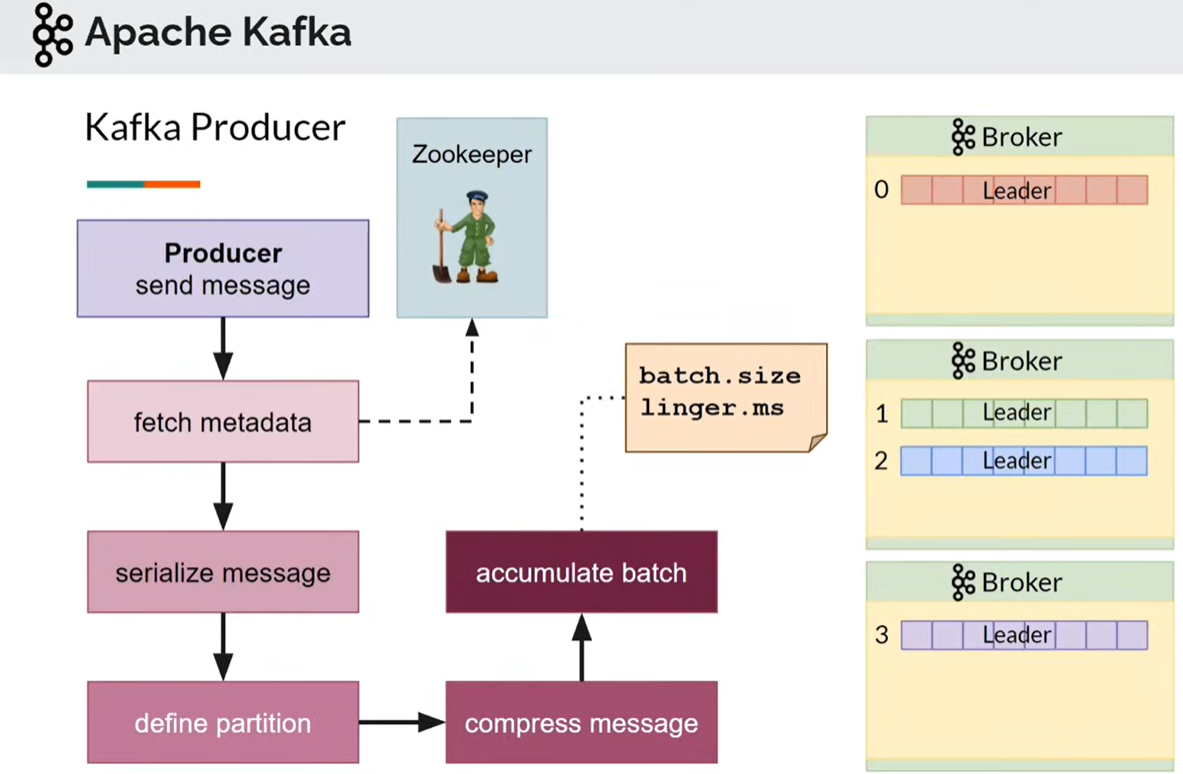
- accumulate batch
- Определяют, в какую партицию топика записывать данные:
- автоматически или по заданным правилам
- define partition:
- explicit partition
- round robix
- key
- Могут быть чем угодно: микросервисы, устройства IoT и другие приложения.
- Поддерживают режимы отправки:
- Синхронный — ждёт подтверждения от Kafka перед отправкой следующего сообщения.
- Асинхронный — отправляет сообщения без ожидания ответа.
- Могут гарантировать доставку с разными уровнями подтверждения (acks):
- acks=0 — без ожидания подтверждения (возможна потеря данных, высокая скорость).
- acks=1 — подтверждение только от лидера партиции (среднее).
- acks=all — подтверждение от всех реплик (максимальная надёжность).
- Процесс produce публикации сообщений
- Модели доставки сообщений delivery semantic
- at most once (не более одного)
- al least once (хотя бы один, возможны дубликаты)
- exactly once (idempotent)
- serialize
- compress
- Модели доставки сообщений delivery semantic
Потребители (Consumers)
- Подписываются на один или несколько топиков, но получают через запрос pull сообщения/события.
- Могут работать как отдельные клиенты или объединяться в группы (Consumer Groups) для параллельной обработки сообщений.
- В группе консьюмеров каждый участник обрабатывает свою часть партиций.
- Kafka гарантирует, что каждое сообщение будет обработано хотя бы одним потребителем в группе.
Топики (Topics)
Логическая тема, куда продюсеры отправляют сообщения, а потребители их читают
- Логическая категория или тема, куда Продюсеры отправляют сообщения, а Потребители их читают.
- Представляют собой поток сообщений, где каждое имеет: ключ, значение, метаданные.
- Не удаляют сообщения сразу после обработки — данные хранятся в топике в течение заданного времени.
- Могут быть разделены на партиции, что позволяет распределять нагрузку между Продюсерами и Консьюмерами.
Партиции (Partitions)
Подмножество данных внутри топика, которое позволяет распределять нагрузку и масштабировать обработку сообщений. Каждый топик состоит из одной или нескольких партиций
1) Каждый топик состоит из одной или нескольких партиций (разделов). 2) Сообщения внутри партиции хранятся в строгом порядке (FIFO — “первым пришёл, первым обработался”). 3) Разные партиции могут обрабатываться параллельно, что увеличивает производительность Kafka. 4) Каждое сообщение в партиции получает уникальный порядковый номер (offset), который используется Потребителями для чтения данных. 5) Продюсеры могут отправлять сообщения в партиции автоматически или по определённому ключу (например, все заказы одного клиента попадут в одну партицию). 6) Один потребитель из Группы Консьюмеров читает данные только из своей партиции, что позволяет распределять нагрузку. 7) Повышение надежности обеспечивается через репликацию: выделяют Leader Replica (основная копия данных партиции) и Follower Replica (копирует данные лидера в синхронном или асинхронном режиме).
Брокер (Broker)
сервер Kafka, который отвечает за хранение, управление и передачу данных внутри кластера
1) Хранят топики и их партиции. 2) Обрабатывают запросы Продюсеров на запись и Консьюмеров на чтение данных. 3) Управляют репликацией партиций для отказоустойчивости. 4) Автоматически перераспределяют нагрузку при добавлении новых брокеров в кластер.
Кластер (Cluster)
группа брокеров, работающих вместе для масштабирования и распределённой обработки данных
1) Это группа брокеров, работающих вместе для масштабирования и распределённой обработки данных. 2) Использует ZooKeeper или KRaft для координации (назначает лидеров партиций, отслеживает состояние брокеров). 3) Позволяет добавлять новые брокеры без остановки системы. 4) Поддерживает автоматическое восстановление при сбоях отдельных узлов.
Паттерны
- Один producer создается для отправки сообщений для быстродействия (fetch metadata sync тяжелая операция)
Модель
Каждое сообщение (event или message) в Kafka состоит из:
- ключа
- значения
- таймстампа
- и опционального набора метаданных (так называемых хедеров)